SkillCorner Open Data #2: Comparación de jugadores con z-scores
.
En la primera entrega de la serie Open Data, exploramos cómo visualizar datos físicos utilizando gráficos de barra y radares de nuestra librería de visualización, analizando métricas individuales como PSV-99 y acciones de alta intensidad.
Sin embargo, en el scouting y el análisis de los partidos, a menudo queremos responder a una pregunta más detallada como ¿Quiénes son los jugadores más explosivos? o ¿Qué jugadores ofrecen la mejor combinación de distancia e intensidad?
Para lograrlo, debemos ir más allá de las métricas individuales y combinar múltiples variables en una sola puntuación. En este post, presentamos los z-scores, una herramienta estadística que nos permite estandarizar diferentes métricas y construir perfiles integrales.
1 - ¿Qué es un z-score?
Un z-score (o puntuación estándar) nos indica a cuántas desviaciones estándar de la media se encuentra un punto de datos.
- Un z-score de 0 indica un jugador que rinde al nivel promedio.
- Un z-score de +2.0 significa que el jugador está significativamente por encima del promedio (aproximadamente. dentro del mejor 2,5% de la liga).
- Un z-score de -2.0 indica un rendimiento significativamente inferior al promedio.
La ventaja clave de los z-scores es que nos permiten comparar métricas fundamentalmente diferentes en la misma escala. Por ejemplo, una vez estandarizados, se pueden combinar y comparar la distancia (medida en metros) y las acciones de alta intensidad (medida en conteos).
2 - Filtrado y normalización
Al igual que en nuestro cuaderno anterior sobre visualización de datos, es importante empezar filtrando el conjunto de datos con el que se trabaja. En este caso, volvemos a utilizar los datos abiertos de SkillCorner de la temporada 2024/25 de la A-League australiana.
Al trabajar con datos físicos, se recomienda un umbral mínimo de cinco partidos, y también se debe definir el grupo de posición que se desea analizar. Además, aplicamos la normalización a las métricas utilizadas, un proceso explicado con más detalle en el artículo anterior.
# Filtrar por jugadores con al menos 5 partidos
df_filtered = df[df['count_match'] >= 5].copy()

# Filtrar por un grupo de posición específico (ej. Mediocampista)
df_filtered = df_filtered[df_filtered['position_group'] == 'Midfield'].copy()

# Ejemplo por 90 minutos
df_filtered['hi_count_p90'] = (df_filtered['hi_count_full_all'] / df_filtered['minutes_full_all']) * 90
df_filtered['total_dist_p90'] = (df_filtered['total_distance_full_all'] / df_filtered['minutes_full_all']) * 90

# Ejemplo por 60 minutos de balón en juego (BIP)

# Combinando TIP (equipo en posesión) y OTIP (equipo rival en posesión)
df_filtered['hi_count_p60_bip'] = (
  (df_filtered['hi_count_full_tip'] + df_filtered['hi_count_full_otip']) * 60 /
  (df_filtered['minutes_full_tip'] + df_filtered['minutes_full_otip'])
)
Ahora disponemos de un dataframe refinado (df_filtered) que incluye únicamente a los mediocampistas con más de cinco partidos jugados, junto con las métricas relevantes normalizadas. Esto proporciona una base limpia para construir z-scores compuestos.
3 - Definición de la función compuesta
La siguiente función de Python automatiza este proceso. La función agrupa las métricas, calcula sus z-scores individuales, los promedia y, a continuación, vuelve a normalizar el resultado final para que la puntuación compuesta tenga una media de 0 y una desviación estándar de 1.
#--- 3. FUNCIÓN DE Z-SCORE COMPUESTO ---
def calculate_composite_zscores(df, metrics_group1, metrics_group2, metrics_group3,
                              name_g1='intensity', name_g2='volume', name_g3='explosivity'):
  """
Calcula Z-scores compuestos para 3 grupos.
Grupo 1 y 2: Valores brutos más altos son mejores.
Grupo 3: Valores brutos más bajos (tiempo) son mejores (invertido).
  """
  df_result = df.copy()

#--- GRUPO 1
  raw_avg_g1 = ((df[metrics_group1] - df[metrics_group1].mean()) / df[metrics_group1].std()).mean(axis=1)
  # 2. Renormalizar el promedio final para que Media=0 and Desv. Est.=1
  df_result[name_g1] = (raw_avg_g1 - raw_avg_g1.mean()) / raw_avg_g1.std()

  # --- GRUPO 2
  raw_avg_g2 = ((df[metrics_group2] - df[metrics_group2].mean()) / df[metrics_group2].std()).mean(axis=1)
  # 2. 2. Renormalizar el promedio final para que Media=0 y Desv. Est.=1
  df_result[name_g2] = (raw_avg_g2 - raw_avg_g2.mean()) / raw_avg_g2.std()

  # --- GRUPO 3

  z_scores_g3 = (df[metrics_group3] - df[metrics_group3].mean()) / df[metrics_group3].std()
  # 2. Invertirlos (-1) para que los tiempos brutos más bajos sean puntuaciones positivas altas
  raw_avg_g3 = (-z_scores_g3).mean(axis=1)
  # 3. Renormalizar el promedio final para que Media=0 y Desv. Est.=1
  df_result[name_g3] = (raw_avg_g3 - raw_avg_g3.mean()) / raw_avg_g3.std()
  return df_result

# --- 4. EJECUTAR CÁLCULOS ---

# Definiendo nuestros grupos
intensity_metrics = ['hi_count_p90', 'psv99']
volume_metrics    = ['total_dist_p90', 'hi_count_p60_bip']
explosive_metrics = ['timetohsr_top3', 'timetosprint_top3']
# Cambia las definiciones y métricas según consideres
# Generar el dataframe con puntuaciones
df_scored = calculate_composite_zscores(
  df_filtered,
  intensity_metrics,
  volume_metrics,
  explosive_metrics,
  name_g1='Intensity_Composite',
  name_g2='Volume_Composite',
  name_g3='Explosivity_Composite'
)
4 - Ranking de jugadores por categoría de métrica
Ya hemos definido tres grupos de métricas físicas y calculado los z-scores. En otras palabras, la mayor parte del trabajo pesado está hecho, y ahora podemos centrarnos en explorar los resultados y clasificar a los jugadores en los diferentes grupos.
# Previsualizar la lista de los jugadores más explosivos
(df_scored[['player_name','Intensity_Composite']].sort_values('Intensity_Composite', ascending=False).head(10))
También podemos visualizar los 10 mejores jugadores en intensidad con un gráfico de barras de la librería de visualización de SkillCorner.
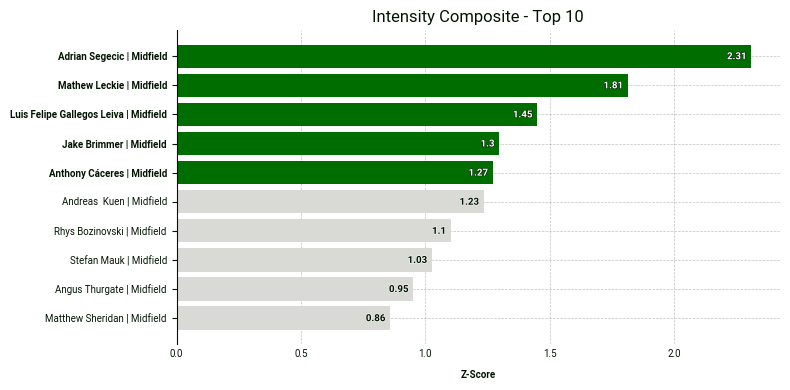
A continuación se muestra el código para producirlo:
# 1. Ordenar por la métrica compuesta y tomar los 10 mejores
top_10_physical = df_scored.sort_values('Intensity_Composite', ascending=False).head(10).copy()

# 2. Crear la etiqueta personalizada del gráfico (Nombre | Posición)
top_10_physical['plot_label'] = (
  top_10_physical['player_name'] + ' | ' + top_10_physical['position_group']
)

# 3. Obtener los IDs de los 5 mejores para resaltarlos en verde
top_5_ids = top_10_physical['player_id'].head(5).tolist()
# 4. Crear el gráfico de barras
fig, ax = bar.plot_bar_chart(
  df=top_10_physical,
  metric='Intensity_Composite',
  label='Z-Score',
  primary_highlight_group=top_5_ids,   # These 5 will be green
  primary_highlight_color='#006D00',    # SkillCorner Green
  add_bar_values=True,
  data_point_id='player_id',
  data_point_label='plot_label',
  plot_title='Intensity Composite - Top 10'
)
5 - Trazado de un gráfico de dispersión
Observar una sola métrica o un grupo de métricas de forma aislada no siempre es suficiente para comprender totalmente el perfil de un jugador. Aquí es donde los gráficos de dispersión adquieren un valor especial. Al trazar dos grupos de métricas uno frente al otro, nos permiten evaluar cómo rinden los jugadores en múltiples dimensiones a la vez.
Esto facilita la identificación de los jugadores que destacan en ambas áreas, así como de aquellos que emergen como claros valores atípicos (outliers). En el gráfico de dispersión que se muestra a continuación, combinamos z-scores compuestos para dos categorías clave: intensidad y explosividad.
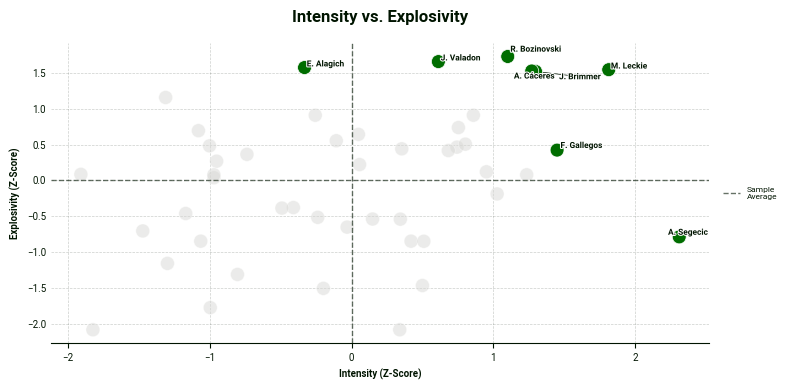
Una conclusión que podemos extraer de este gráfico es que Adrian Segečić es un jugador destacado en la categoría de intensidad con un z-score superior a 2. Además, los jugadores de la esquina superior derecha sobresalen en ambas categorías.
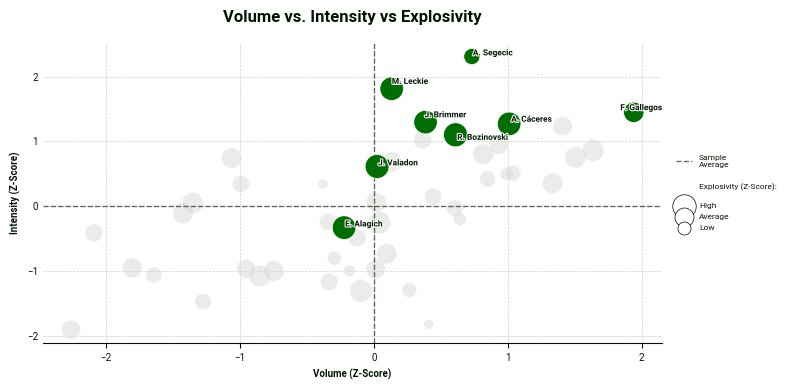
Por último, también podemos añadir otra capa: un tercer grupo de métricas ilustrado mediante el ajuste del tamaño de la burbuja de cada jugador. En este gráfico de dispersión, Luis Gallegos lidera la categoría de volumen, mientras que Matthew Leckie y Anthony Caceres también destacan en explosividad, esta vez ilustrada por el tamaño de sus burbujas.
#  --- 5. GRÁFICO DE DISPERSIÓN USANDO df_scored ---

# Identificar a los 5 mejores en Intensidad y Explosividad para resaltarlos y contrastarlos con el Volumen, usando el tamaño de la burbuja.

top_5_intensity_ids = df_scored.sort_values('Intensity_Composite', ascending=False).head(5)['player_id'].tolist()
top_5_explosive_ids = df_scored.sort_values('Explosivity_Composite', ascending=False).head(5)['player_id'].tolist()
highlight_players = list(set(top_5_intensity_ids + top_5_explosive_ids))
fig, ax = scatter.plot_scatter(
  df=df_scored,
  x_metric='Volume_Composite',
  y_metric='Intensity_Composite',
  z_metric='Explosivity_Composite',
  data_point_id='player_id',
  primary_highlight_group=highlight_players,
  data_point_label='player_short_name',
  x_label='Volume (Z-Score)',
  y_label='Intensity (Z-Score)',
  z_label='Explosivity (Z-Score)',
  primary_highlight_color='#006D00',
  plot_title='Volume vs. Intensity vs Explosivity')
6 - Ir más allá
Si deseas explorar más a fondo estos modelos compuestos, puedes encontrar toda la lógica y las plantillas de gráfico de dispersión en nuestro cuaderno de Google Colab. Siéntete libre de adaptar las funciones para construir tus propios perfiles físicos.
Siempre te animamos a compartir tu trabajo en las redes sociales. Si lo haces, por favor, menciona a SkillCorner como la fuente de los datos y etiqueta nuestra cuenta correspondiente en X/Twitter o LinkedIn.
En esta entrega, hemos mostrado cómo los Z-scores te permiten estandarizar diferentes tipos de métricas y detectar los verdaderos valores atípicos. Pero el rendimiento físico es solo una parte de la imagen.
En el próximo post, iremos más allá del atletismo para adentrarnos en el contexto táctico. Mostraremos cómo combinar los datos físicos con métricas de Game Intelligence, como las carreras sin balón, para construir perfiles de jugadores más completos y útiles para la toma de decisiones.